Columns · 인사이트 · AI 평가
같은 AI, 같은 레시피. 그런데 왜 결과는 쓰는 사람에 따라 다를까
인사이트 01 (한국어판)
글 신치훈 (명성심재 대표 · 컴퓨터공학 박사) · 게재 2026. 9. 23. · 약 6분
링크드인에 영어로 먼저 올린 글을 한국어로 옮겼습니다.
짧은 답
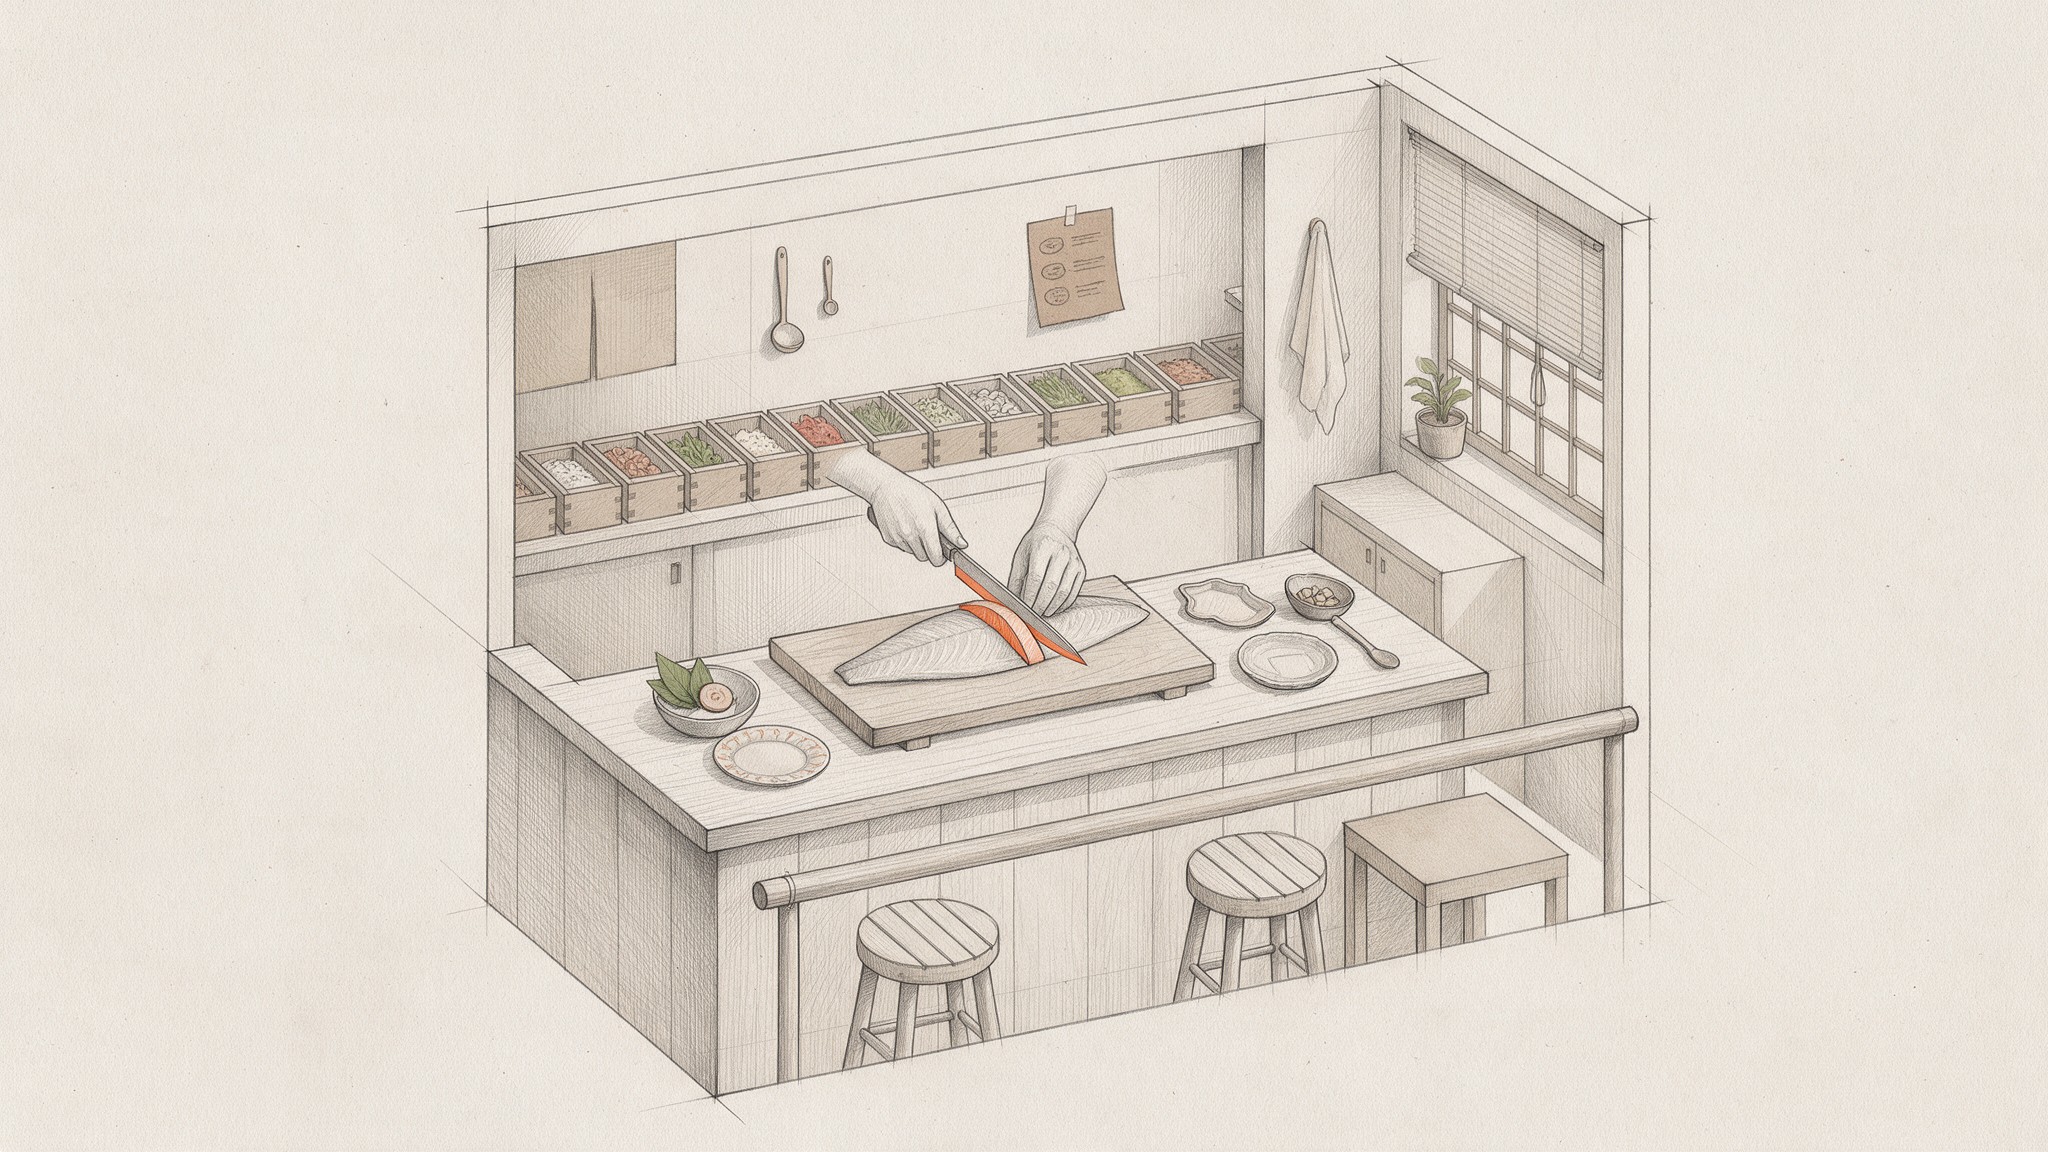
초밥 체인점을 떠올려 봅시다. 가게마다 같은 생선, 같은 밥, 같은 레시피 카드를 받습니다. 그래도 어느 가게가 더 맛있을 수 있습니다. 차이는 흔히 마지막 칼질 한 번에 있습니다.
일터의 AI도 비슷합니다. 영리한 답을 내는 것은 대개 어려운 부분이 아닙니다. 어려운 것은 매번 믿을 만한 결과를 얻는 일입니다. 되풀이되는 부분은 프로그램으로 적어 두는 편이 가장 좋습니다. 사람마다 여전히 다른 것은, AI가 어디서부터 믿을 수 없게 되는지, 그리고 그중 어느 곳이 정말 중요한지를 아는 일입니다.
「기호」가 정말 뜻하는 것
「뉴로심볼릭 AI」라는 말을 들어 보셨을 겁니다. 두 부분을 합친 것입니다.
- 신경망 쪽: 데이터에서 패턴을 배웁니다. 고양이 사진을 많이 보고 고양이 모양을 익히는 것과 같습니다.
- 기호 쪽: 규칙, 논리, 사실을 다룹니다. 점검표와 같습니다.
흔히 AI에 사람 같은 추론을 더하는 것이라고 설명합니다.
기호 쪽은 글로 적어 두고 매번 같은 방식으로 다시 돌릴 수 있는 것들로 이루어져 있습니다. 그런 뜻에서, 그 자리에서 생각하는 사람보다는 프로그램에 더 가깝습니다.
일상 업무에서는 이런 질문이 더 쓸모 있을지 모릅니다. 매번 달라지는 것을 프로그램이 고정할 수 있는가.
진짜 벽: 매번 믿을 만한 결과
AI 모델에는 「온도」라는 설정이 있습니다. 답에 무작위성을 얼마나 넣을지 정합니다. 0으로 두어도 같은 질문에 다른 답이 나올 수 있습니다. 한 모델 회사의 공식 문서도 같은 출력이 보장되지 않는다고 적고 있습니다.
지난 글에서 쓴 2026년 조사(에이전트를 만드는 사람 1,340명)에서, 실제 운영으로 넘어가는 데 가장 큰 걸림돌은 품질이었습니다. 약 세 명 중 한 명이 꼽았습니다. 되풀이 가능성이 그 원인이라는 증거는 아닙니다. 다만 매번 바뀌는 답은 자주 맞더라도 믿기 어렵습니다.
많은 팀이 일을 둘로 나눕니다.
- 워크플로: 코드가 단계를 정하고 AI는 그중 일부를 채웁니다. 선로 위의 기차와 같습니다.
- 에이전트: AI가 스스로 단계를 정합니다. 길을 고르는 택시 기사와 같습니다.
에이전트 만들기에 관해 널리 읽힌 안내서는 워크플로가 「잘 정의된 일에서 예측 가능성과 일관성을 준다」고 말합니다.
코드가 AI의 답을 같게 만들어 주지는 않습니다. 코드가 같게 지킬 수 있는 것은 통과 규칙입니다. 무엇을 통과로 칠지 정하는 고정된 검사입니다. 답은 달라도 규칙은 달라지지 않습니다.
같은 도구, 다른 결과
2023년 하버드와 BCG 연구진은 BCG 컨설턴트 758명에게 현실적인 과제 18개를 AI와 함께 풀게 했습니다. AI가 잘하는 과제의 범위를 「경계선 안쪽」이라고 불렀습니다.
- 경계선 안쪽에서는 AI를 쓴 컨설턴트가 과제를 12.2% 더 많이 끝냈습니다.
- 속도는 25.1% 빨랐고, 품질은 40% 넘게 높았습니다.
- 경계선 안쪽에서는 실력이 낮은 쪽이 더 많이 올랐습니다. 43% 올랐고, 실력이 높은 쪽은 17% 올랐습니다.
- 경계선 바깥, 곧 AI에게 어렵도록 고른 과제에서는 AI를 쓴 컨설턴트가 정답을 맞힐 가능성이 19%포인트 낮았습니다. 100건마다 정답이 약 19건 적은 셈입니다.
잘한 사람들은 일하는 방식이 제각각이었습니다. 어떤 사람은 일을 자신과 AI 사이에 나눴고, 어떤 사람은 처음부터 끝까지 AI와 함께 일했습니다.
연구 한 편이고, 2023년의 AI이며, 경계선은 모델이 바뀌면 움직입니다. 그래서 가볍게 받아들입니다. 저희에게는 차이가 옮겨 가고 있다는 신호로 읽힙니다. 「그 일을 얼마나 잘하느냐」에서 「그 일이 AI가 잘하는 범위 밖인지 알아보느냐」로. 그것을 알아보려면 여전히 그 일을 제대로 알아야 합니다.
저희 일에서 보는 것
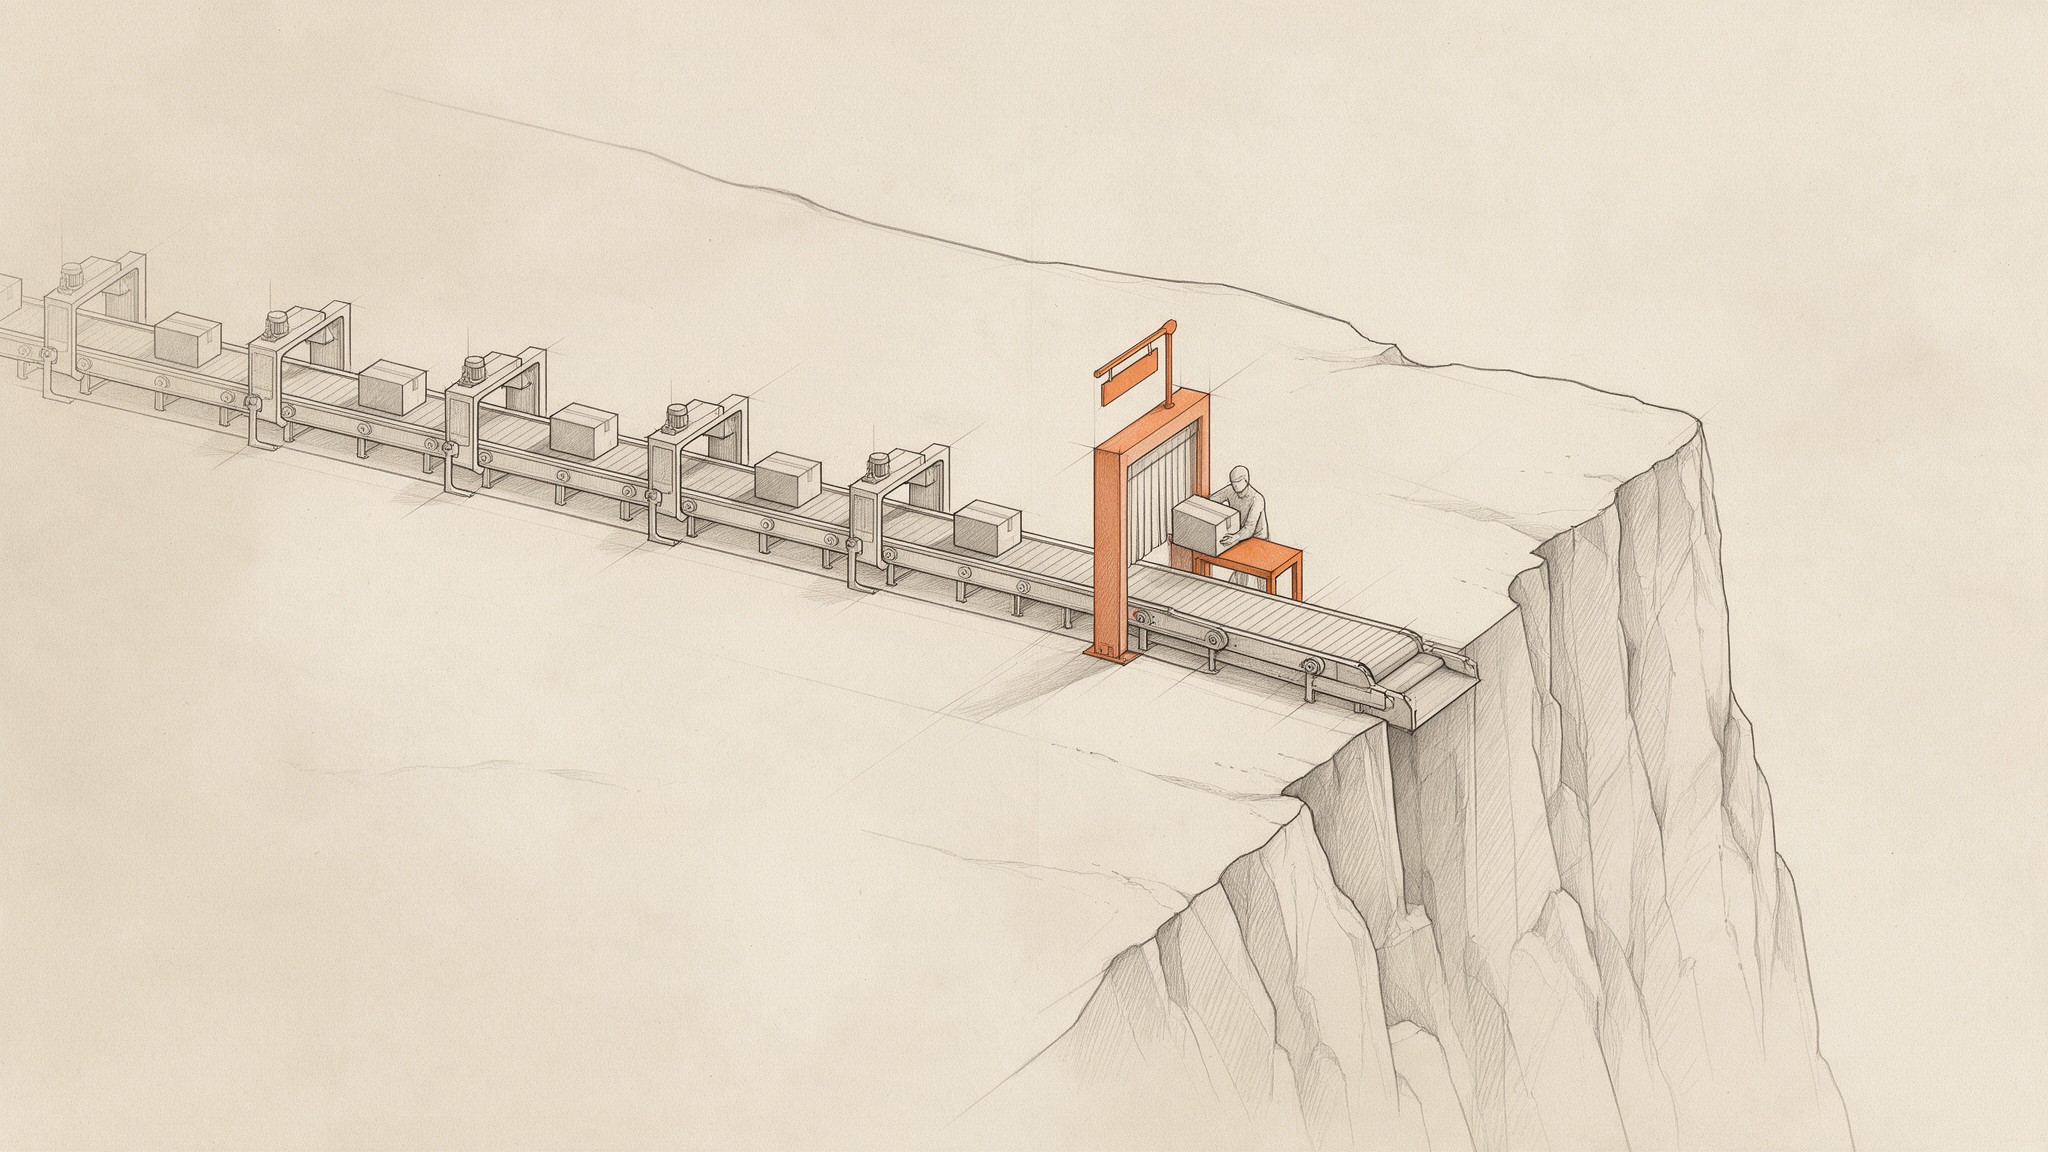
저희는 에이전트의 일을 스크립트로 적은 자동 검사로 감쌉니다. 결과는 그 검사를 통과해야 끝난 것으로 칩니다. 검사가 에이전트를 한결같게 만들지는 않습니다. 통과인지 아닌지의 판정을 한결같게 만듭니다. 검사 자체가 바뀌지 않으면 같은 출력은 같은 판정을 받습니다.
검사를 어디에 두고 무엇을 볼지는 여전히 사람이 정합니다. 저희에게 가장 중요한 곳은 지난 글에서 말한 되돌릴 수 없는 지점입니다. 제출, 결제, 발송입니다.
검사에는 한계가 있습니다. 누군가 미리 생각한 것만 잡습니다. 그래서 아주 쓸모 있는 순간은, 검사를 모두 통과했는데도 일이 잘못된 때일 수 있습니다. 누군가 그것을 알아차리고 새 검사로 바꿔야 합니다.
그렇다면 여기서 더 중요한 것은 프로그램일까요, 사람일까요?
반대편의 이야기
게시하기 전에 이 글에 대한 가장 강한 반론을 모았습니다.
- 체인점은 차이를 없애려고 존재합니다. 가게마다 칼질이 다르면 체인은 그것을 결함으로 보고 교육으로 없앱니다.
- 한 사람이 찾은 것은 글로 적을 수 있습니다. 누군가 AI가 어디서 실패하는지 알면 그것이 검사가 됩니다. 그러면 그 사람의 강점은 프로그램의 일부가 됩니다.
- 느린 곳을 고치라. 잘 알려진 공장 이론인 「제약 이론」은 생산 라인이 가장 느린 공정만큼만 만들어 낸다고 말합니다. 그래서 흔한 조언은 그 공정을 고치라는 것입니다.
- 어떤 실패는 나중에야 드러납니다. 실제 결정이 내려진 뒤, 고객에게서 나타납니다. 알려진 약점에 강한 팀도 비싼 새 실패는 놓칠 수 있습니다.
- 검사가 많다고 늘 좋은 것은 아닙니다. 빠른 팀은 검사를 많이 더하면서 헛경보와 관리 부담도 함께 늘릴 수 있습니다.
타당한 지적입니다. 「프로그램이냐 사람이냐」가 맞는 질문이 아닐 수 있다는 뜻입니다.
더 나은 그림: 어떤 실패가 중요한지 고르기
초밥 체인을 다시 생각해 봅시다. 장인의 요령 하나가 레시피 카드에 들어갈 때마다 모든 가게가 나아집니다. 하지만 어떤 요령을 적을 만한지는 여전히 장인이 정합니다.
AI 일도 비슷할 수 있습니다. AI가 믿을 수 없게 되는 곳을 「경계」라고 부릅시다. 경계는 많고 대부분 작습니다. 몇 곳은 되돌릴 수 없는 지점 바로 앞에 있어서, 거기서 난 실수는 되돌릴 수 없습니다.
그래서 오래 남는 능력은 세 가지 결정일지 모릅니다.
- 어떤 실패가 중요한가? 대개 되돌릴 수 없는 지점을 넘어갈 수 있는 실패입니다.
- 어떻게 잡을 것인가? 알맞은 자리의 검사로, 또는 고정된 검사로 잘 판단할 수 없을 때는 사람으로.
- 언제 그 검사를 믿을 수 있는가? 헛경보가 너무 많지 않으면서 실제 실패를 잡을 때만.
좋은 결정 하나하나가 프로그램의 일부가 되고, 라인 전체가 나아집니다. 에이전트들이 점점 비슷해진다면, 이 결정들이 팀 사이에 여전히 차이를 만드는 몇 안 되는 것 가운데 하나일지 모릅니다.
열린 질문
여러분 조직에서는 어떤 AI 실패가 정말 중요한지 누가 정합니까? 그리고 그 일은 지금 어떻게 평가받고 있습니까?